根据之前会议记录,先看ar-trigger中的网络升级
首先学习如下论文架构:
Deep Isotonic Embedding Network: A flexible Monotonic Neural Network
Modeling Task Relationships in Multi-task Learning with Multi-gate Mixture-of-Experts
model- v2线性加价模型:接单概率 = sigmoid(斜率 × 加价倍数 + 截距)。
目的还是为了让ddt和ar之间保证单调递增关系,网络结构如下。先分为ddt,cate,dense三类,ddt做单调约束,其他两类正常走全连接层。(好像是dien的单变量极简版)
最后为了保证单调性设置输出为 $ar = sigmoid ({a_1}*{ddt} +{c_1})$
数学角度来说,由于$∂ar/∂ddt = ar(1-ar) * a_1 $,前一项在0.25-0.5,因此只要保证后一项正数,这在最后使用leaky_relu可以保证。
loss为:
看它的代码里,输出的 o1,a1,c1 分别叫 outputs,mp_r_s,env_r_s 。应该是下面的解释方式:
接单概率 = sigmoid( 加价效应 × 加价倍数  +  环境基线 )
              ↑          ↑        ↑              ↑
           output      mp_r_s    ddt          env_r_s
  原始 feature_mat (batch, num_features)
     │
     ├─ ddt = driver_dynamic_times 那一列 (batch,1) ── 原始值,不归一化 ──────┐
     │                                                                        │
     └─ 其余所有特征 ──► INPUT_LAYER ──► x1 (batch, final_size)               │
                                            │                                 │
                                      shared_net  (MLP: input→256→128→64→64)  │
                                            │ shared_feat (batch,64)          │
                                      net_s (64→32→2)                         │
                                            │ ab (batch,2)                    │
                                ┌───────────┴───────────┐                     │
                         a1 = leaky_relu(ab[:,0])    c1 = ab[:,1]             │
                          (batch,1) 斜率(≈≥0)         (batch,1) 截距            │
                                └───────────┬───────────┘                     │
                                            ▼                                 ▼
                                o1 = sigmoid( a1 * ddt + c1 )  ◄──────────────┘
                                            │
                                   accept 概率 (batch,1)
model-v3 学习uplift效应:接单概率 = sigmoid(Σ 逐档权重),每个加价档位(0.1)独立学习一个边际贡献。 这个就和线上文档的对上了。
v3模型使用了一个isotonic embedding,可以一次性输出不同treatment所带来的delta uplift,它的emb具体如下:
ddt = 1.0 → [1, 0, 0, 0, …, 0] # 第 1 档 = 1,其余 0
ddt = 1.5 → [1, 1, 1, 1, 1, 1, 0, …, 0] # 前 6 档 = 1
ddt = 3.1 → [1, 1, 1, 1, …, 1] # 全部 22 档 = 1
每个 wₖ 代表”加价从 levelₖ₋₁ 到 levelₖ 这一档带来的边际 logit 贡献
。
如何保证单调性:predict输出y和22-dim uplift,其中基础价格用leaky_relu,delta用softplus,就保证分段单调增
在离线数据上跑了一下它的两个模型,auc和文档里有点差距,可能我看到的不是最终版?
dp8结构
  │ 1   │ 入口与 defer 收尾               │ 98–109  │ 计时、最终埋点、mock 兜底                         │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 2   │ 配置与上下文初始化              │ 110–151 │ 拉 surgeConfig、init、离线特征、解耦开关          │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 3   │ 供需过滤(是否出动调判定)      │ 153–172 │ DemandSupplyFilterV3/New → 定 IsDPTimes           │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 4   │ 埋点 + 计算前准备               │ 174–208 │ PublicLog 写入、initCustom、InitParams            │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 5   │ Explore 短路                    │ 210–221 │ 命中实验直接返回                                  │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 6   │ 分支 A:不出动调 (!IsDPTimes)   │ 223–413 │ 缓存命中 / 乘客动调 / 司机解耦 / 冒泡最优化       │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 7   │ 分支 B:出动调 + 乘客动调开启   │ 415–641 │ 基础值构建 → PaxSurge → 司机侧 → CalculateDpTimes │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 8   │ 分支 C:出动调 + 乘客动调未开启 │ 642–776 │ 热力图范围 → OptSolve GMV 最优化 → 司机侧         │
  ├─────┼─────────────────────────────────┼─────────┼───────────────────────────────────────────────────┤
  │ 9   │ 最终 metric 收尾                │ 778–781 │ opt 耗时上报                                      │
` ├─ 【分支A】IsDPTimes = false(不需要加价) │ ├─ PaxSurge 关闭 → 返回 dpTimes=1.0。# 不加价不动调 │ └─ PaxSurge 开启 → 仍有乘客动调(低供需时也可能调高) │ ├─ 有 OD 缓存 → 走司机解耦 + 热力图写回,直接返回 │ └─ 无缓存 → PaxSurge.PaxSurge() + TR上限 + 司机解耦 + BubbleOpt`
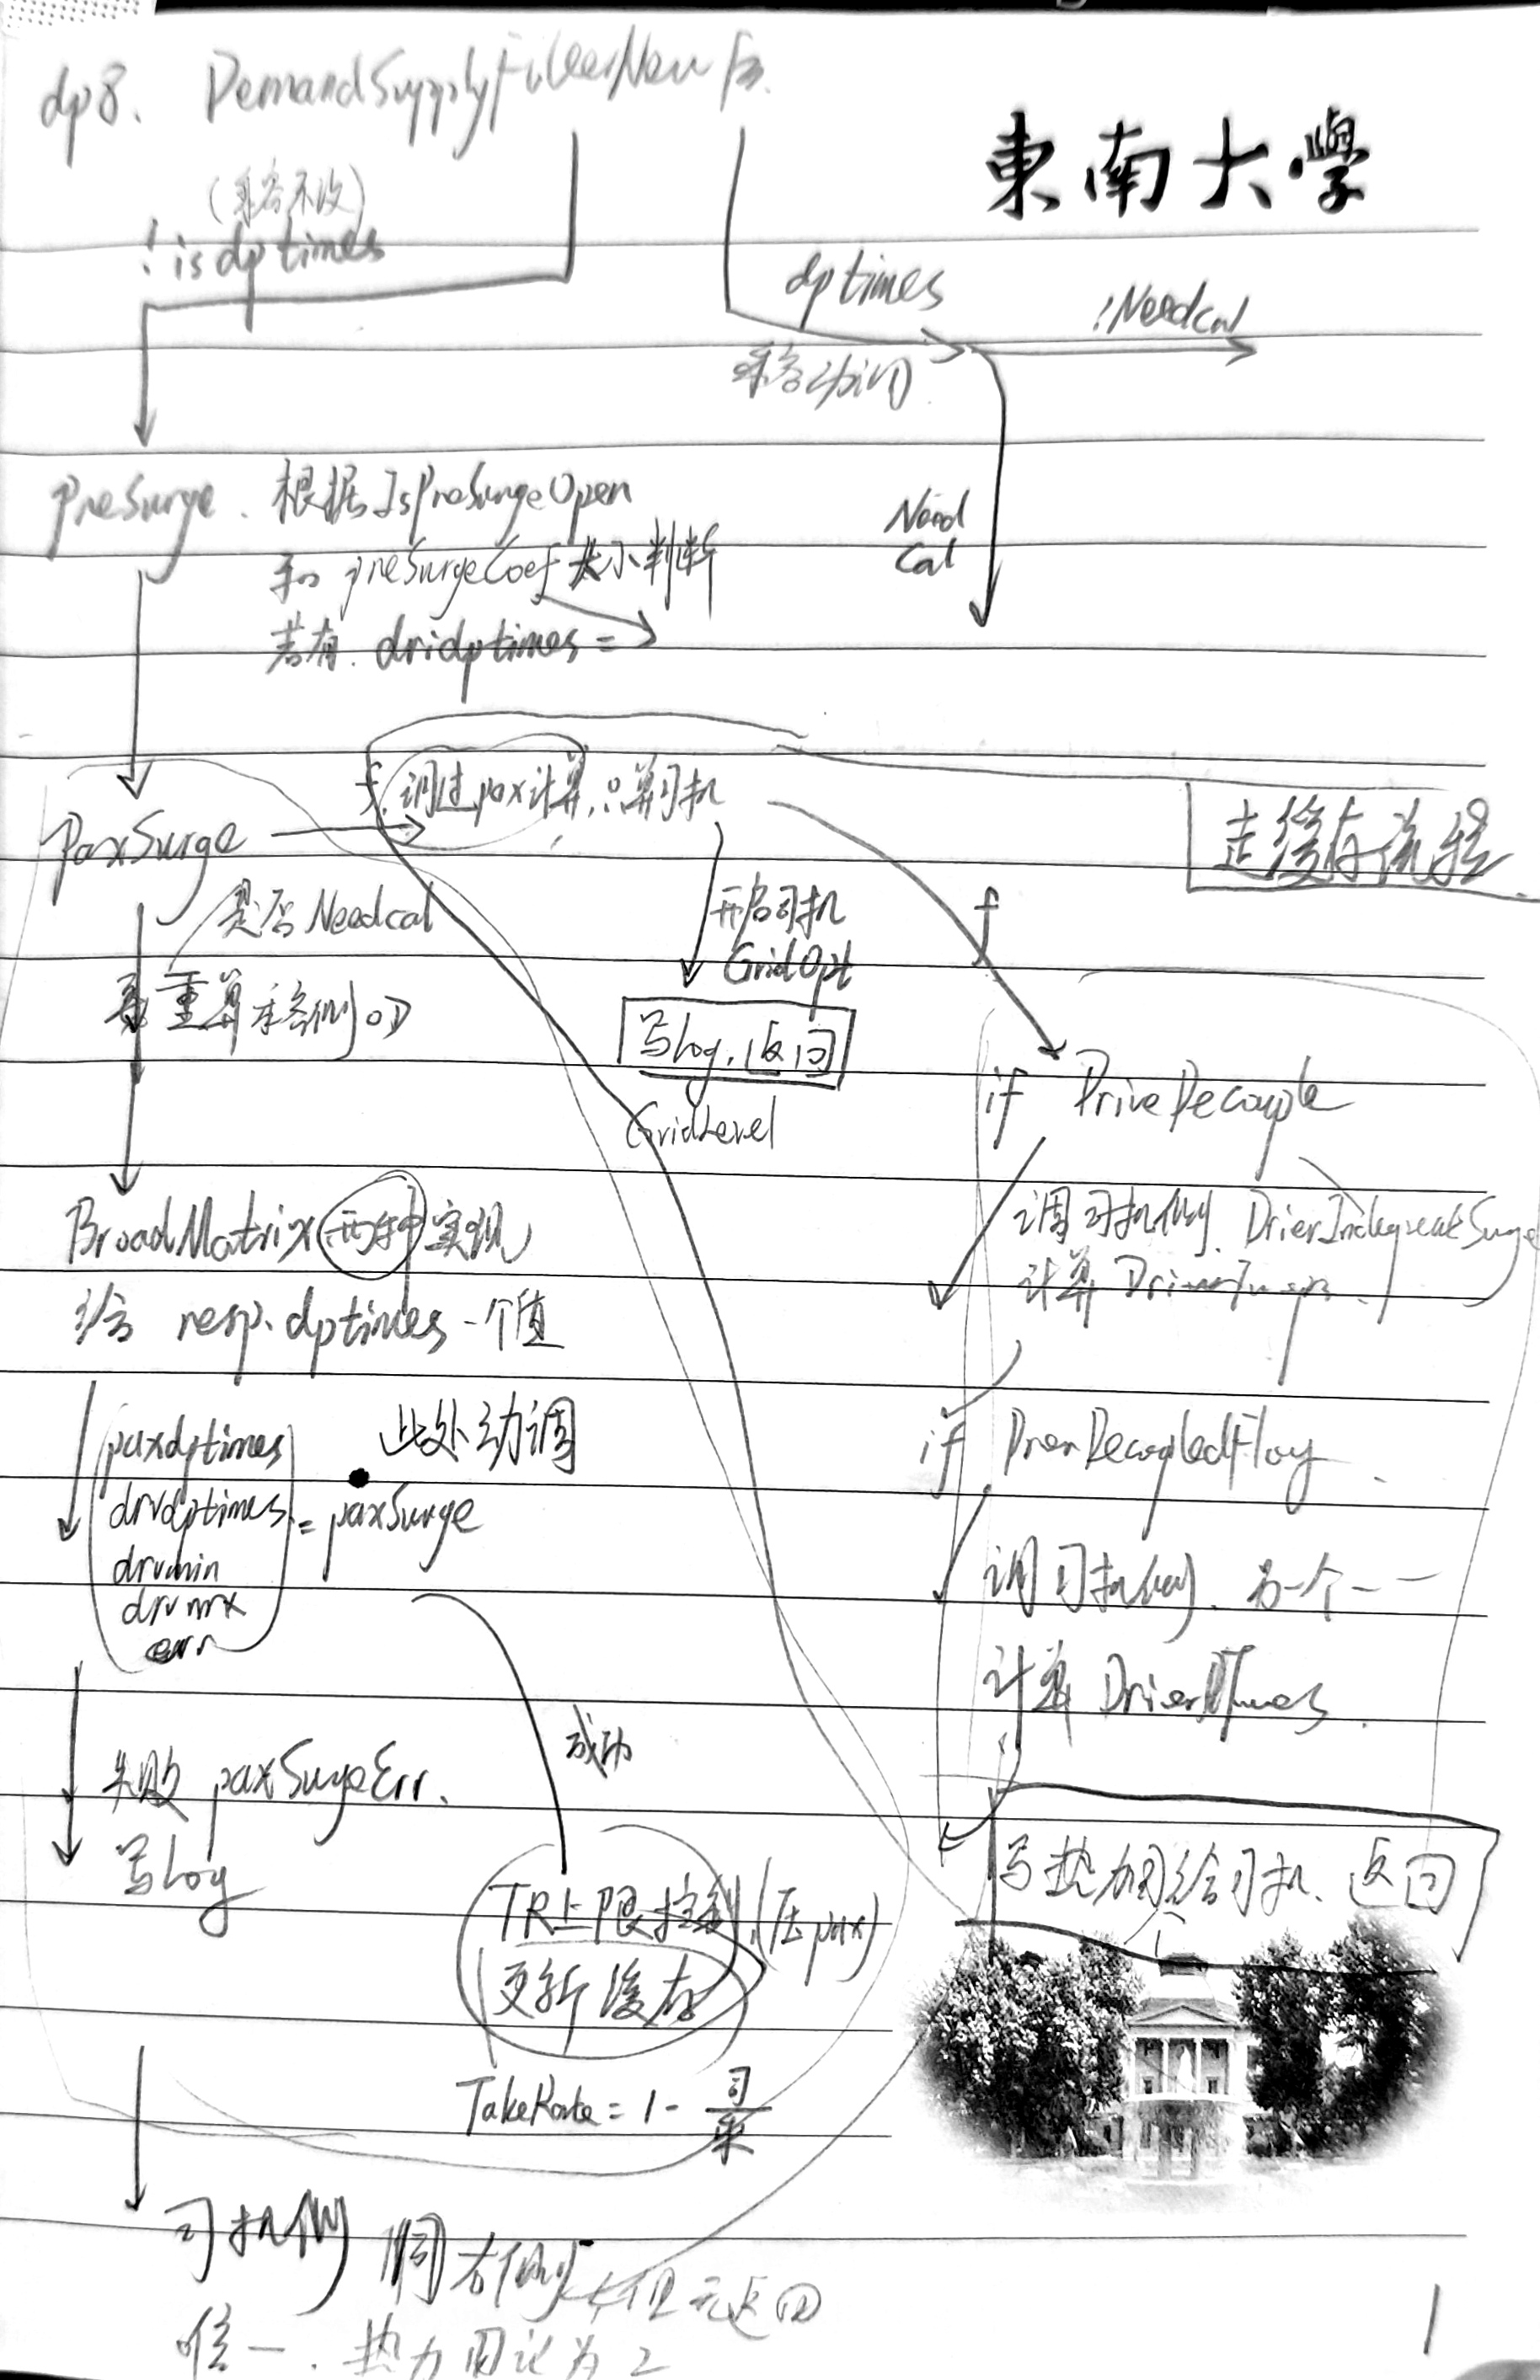
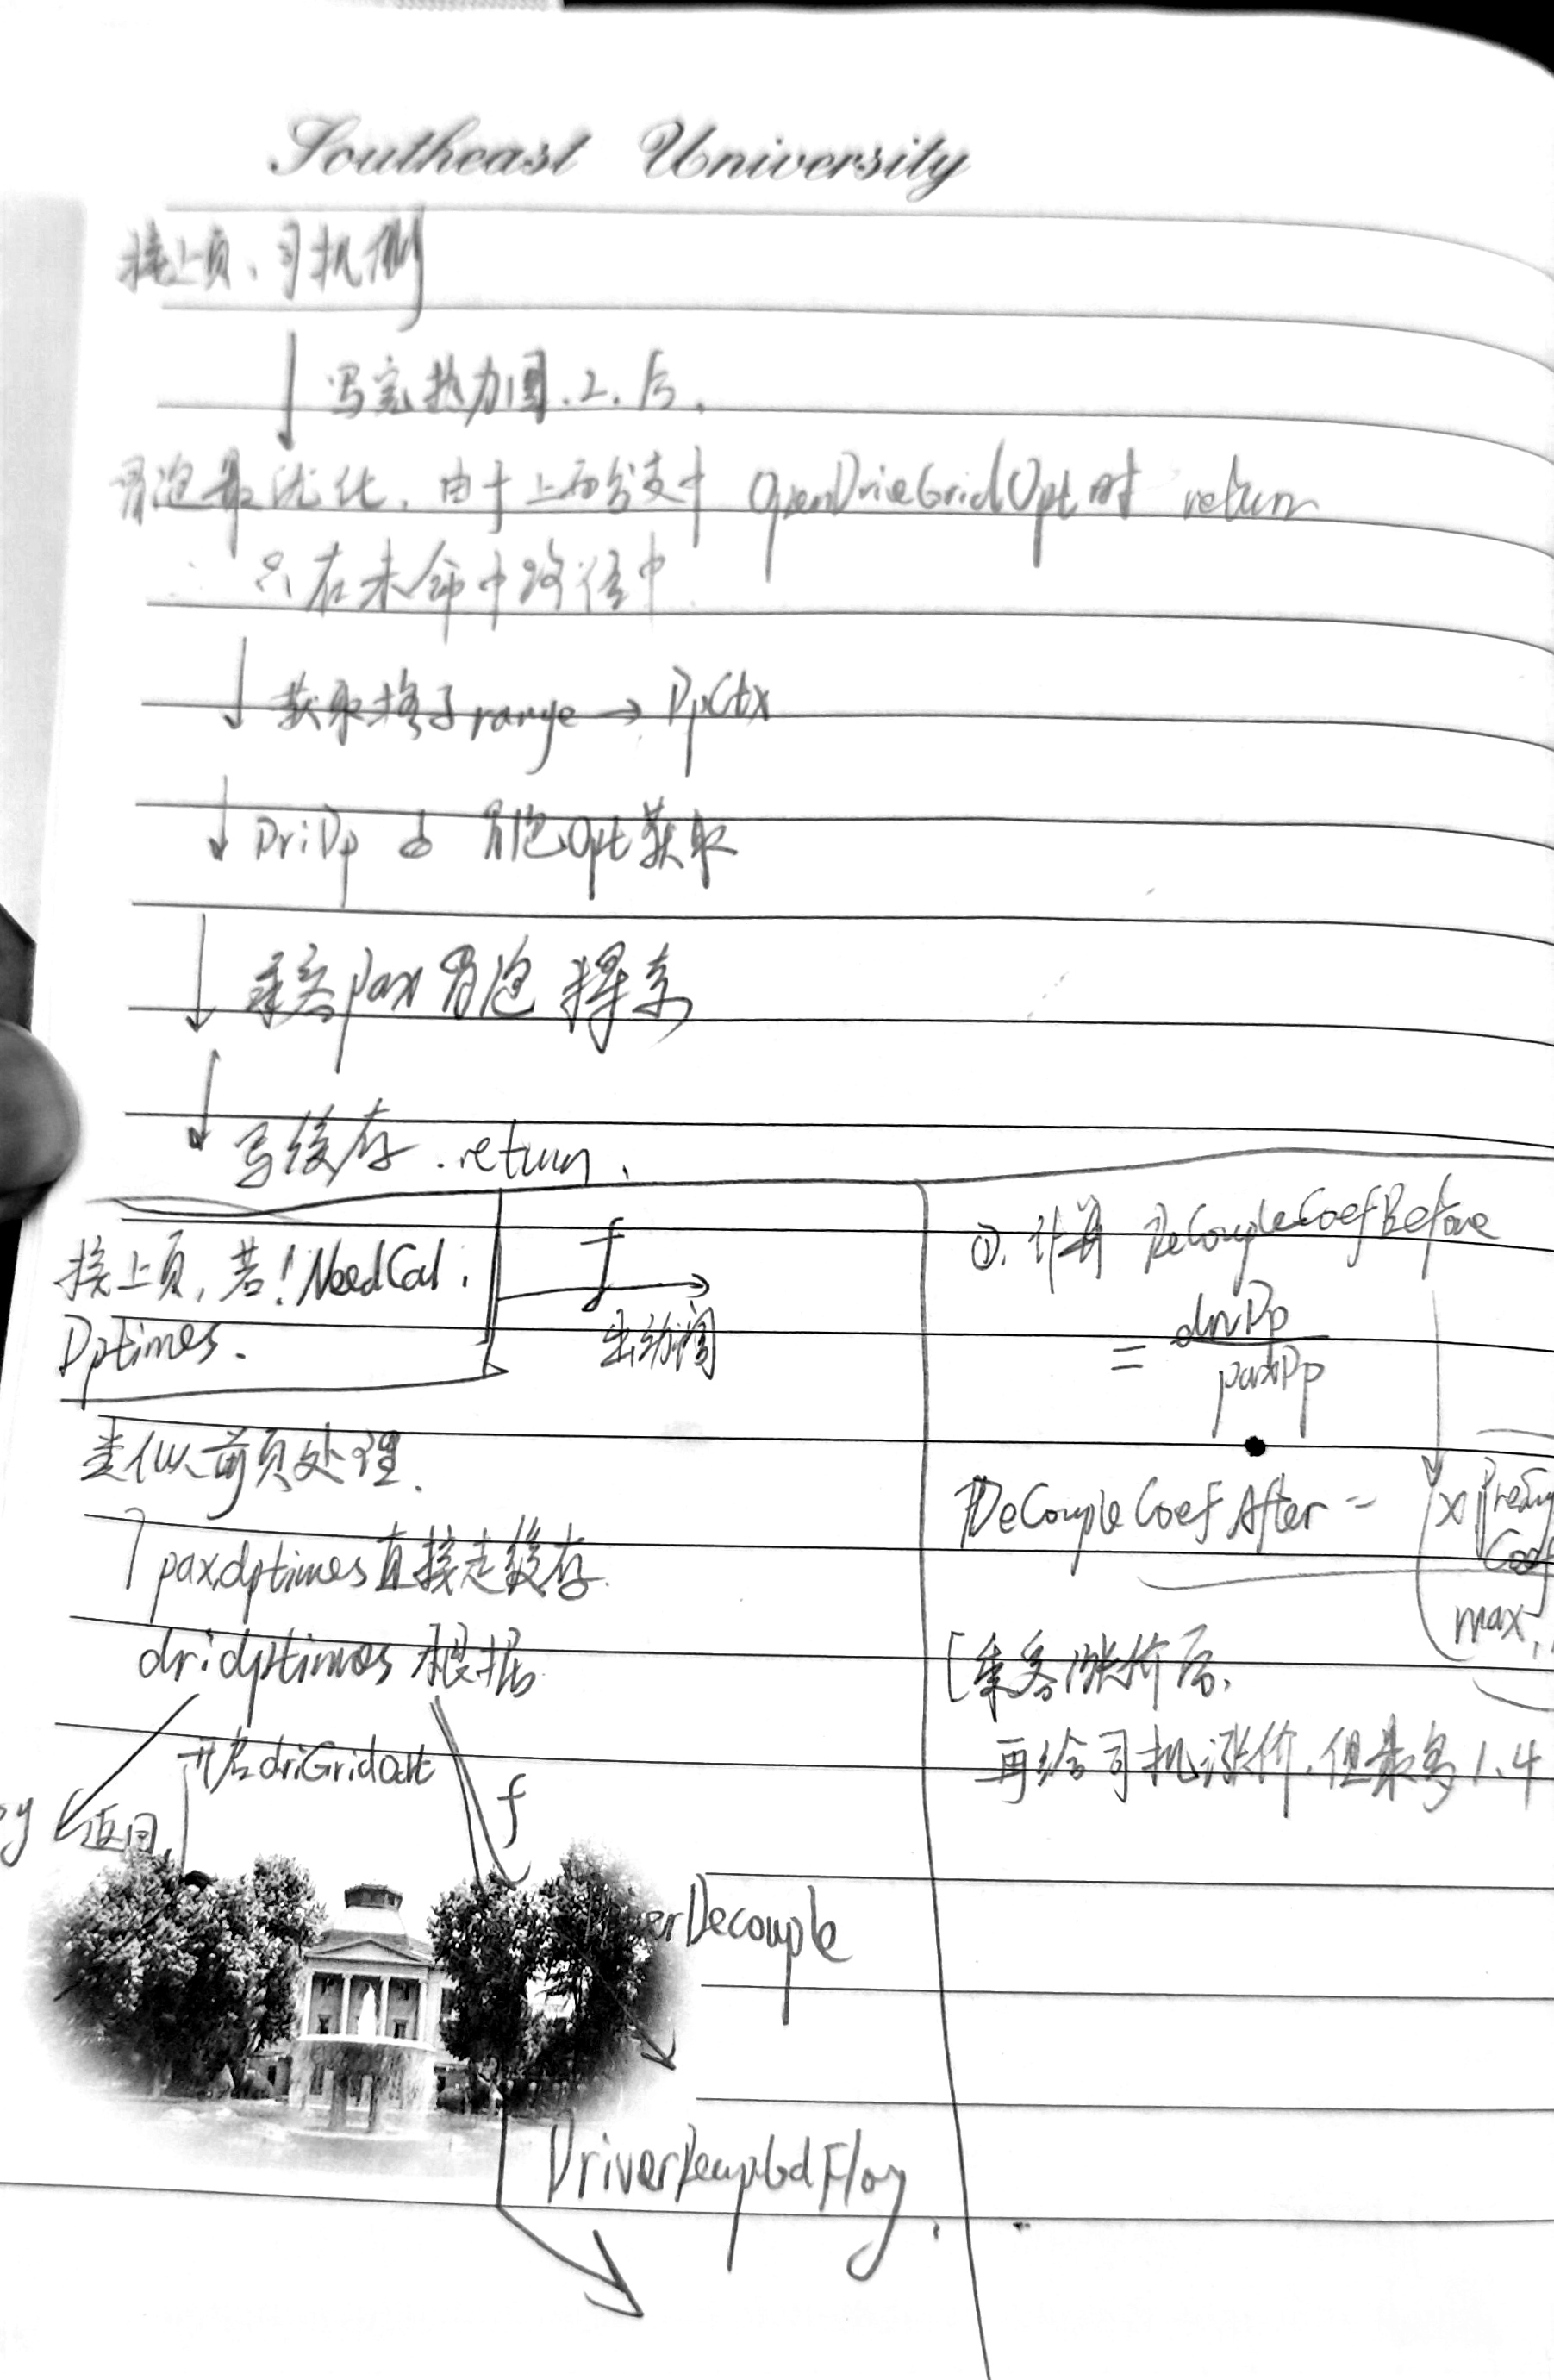
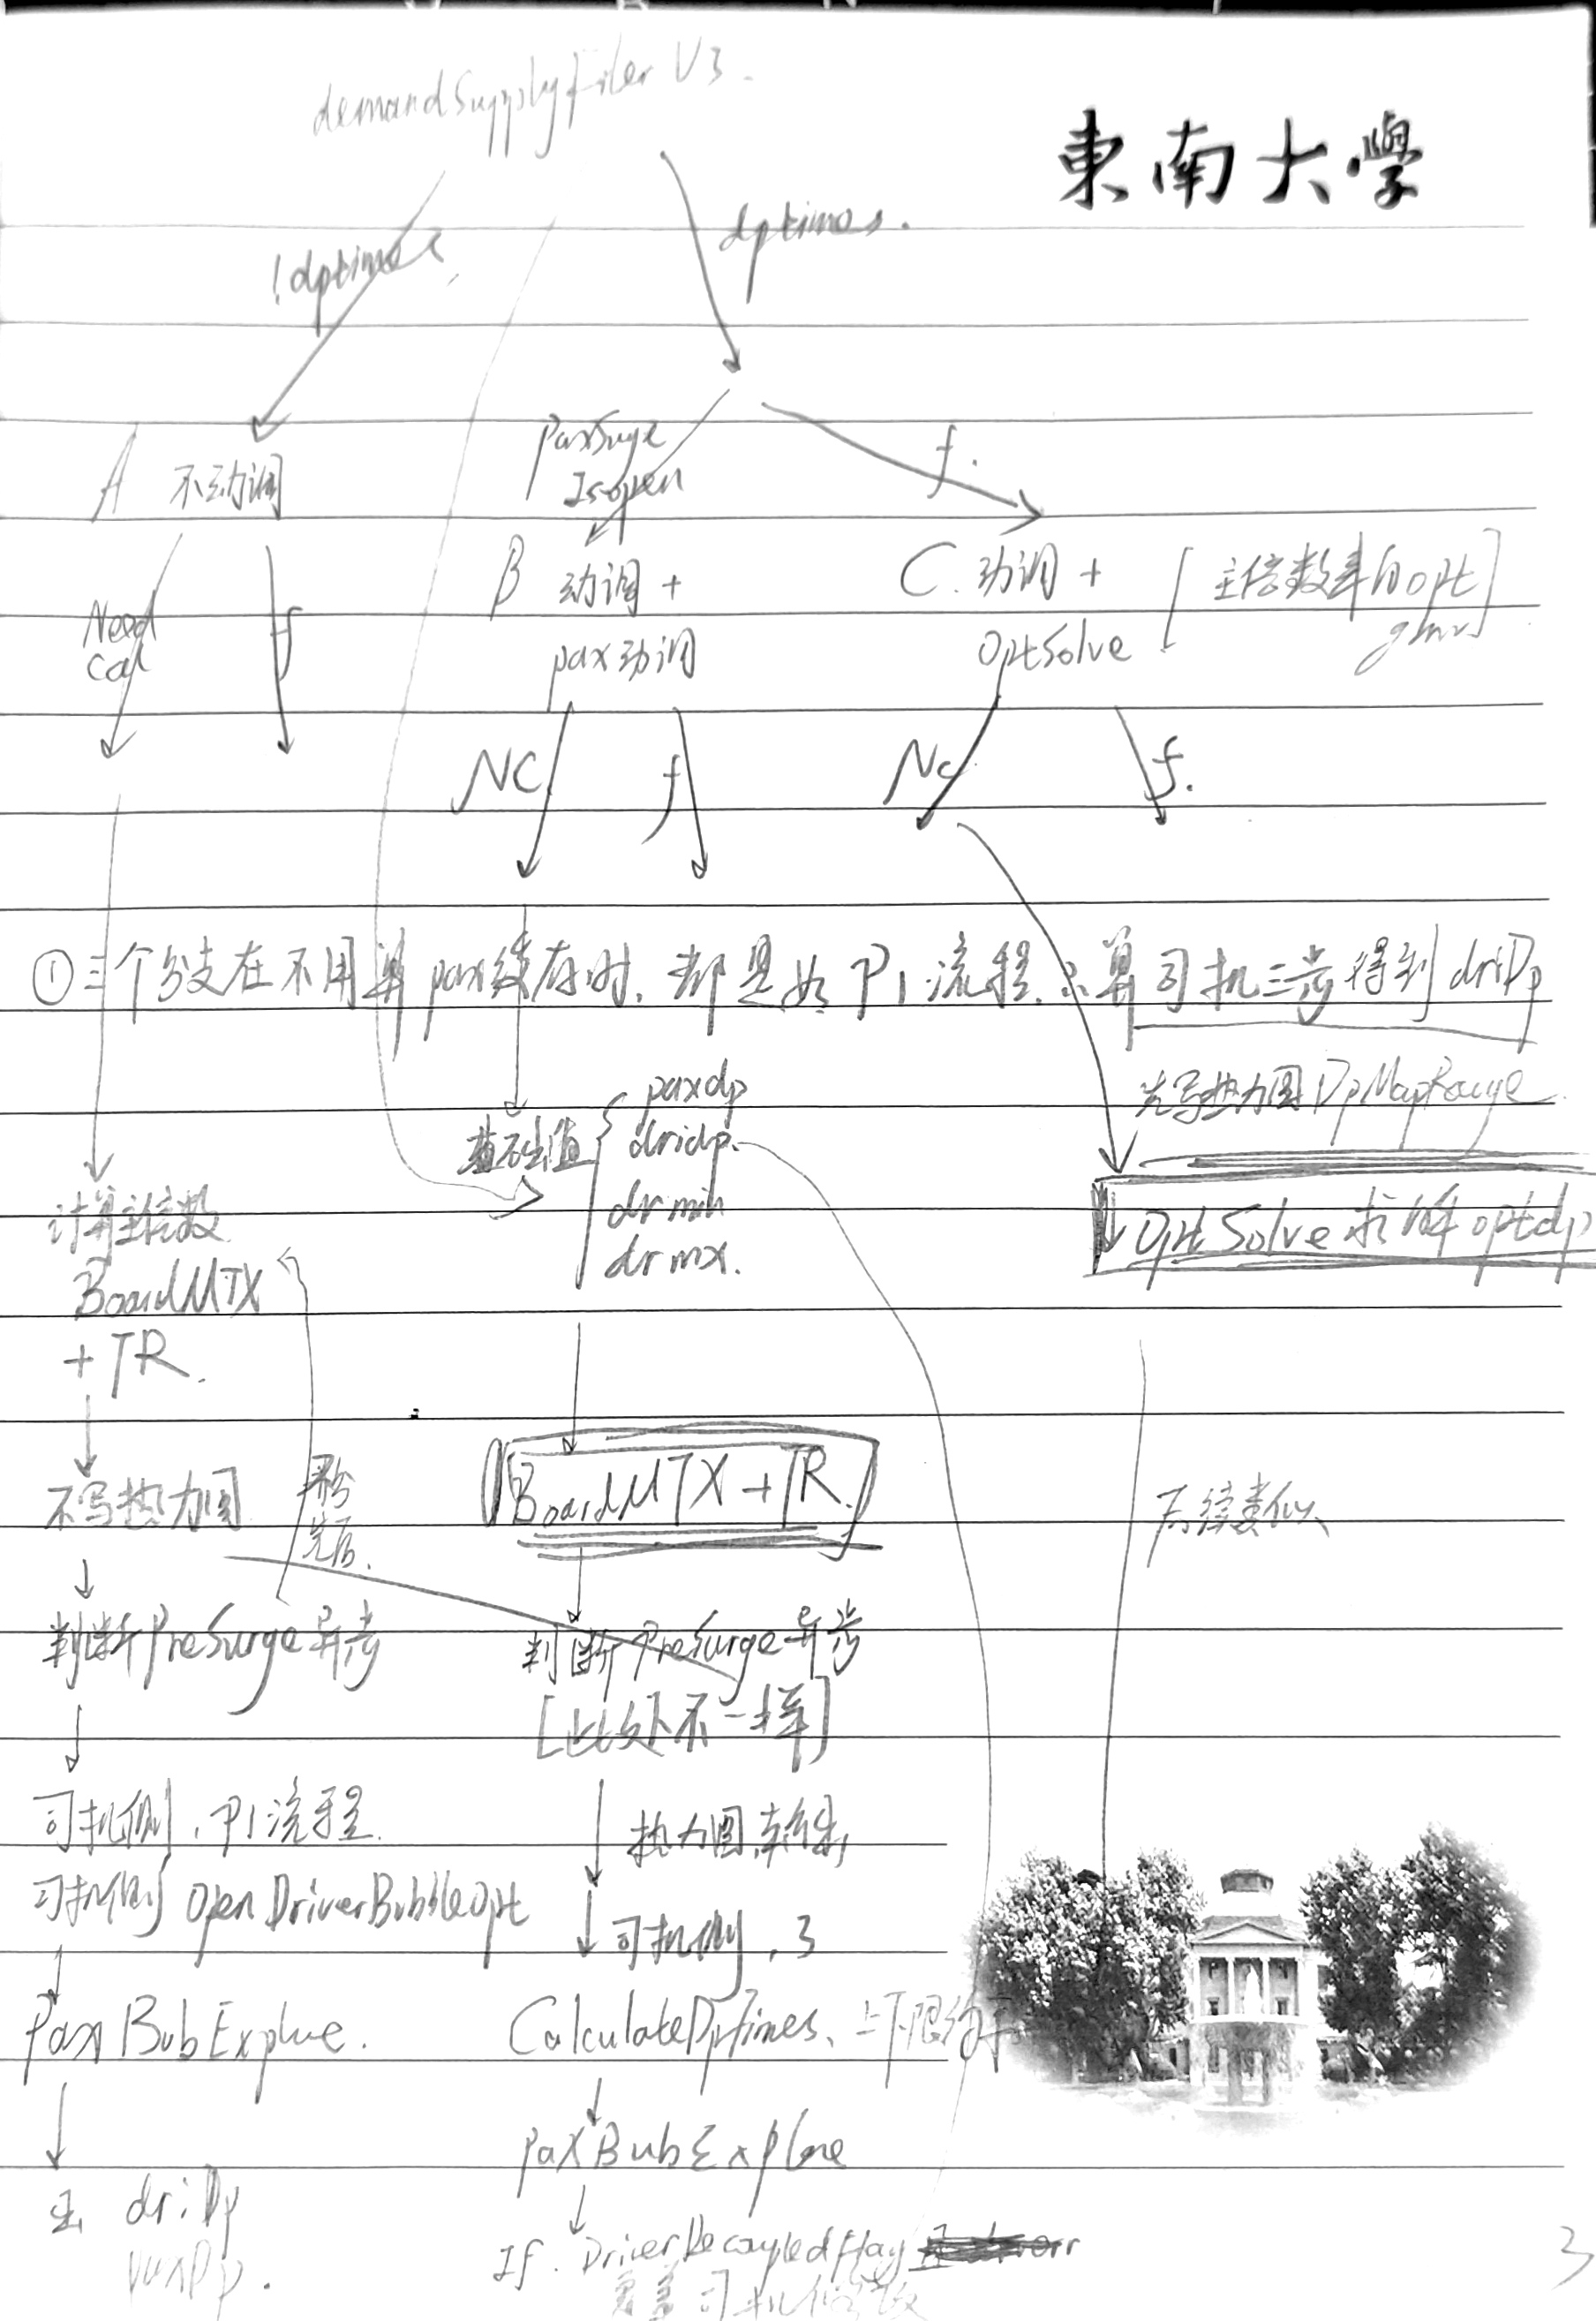
本策略分三个分支,分别对应如下。每个分支又分为需要重计算pax侧需求和不需要重计算。每个分支的逻辑都是(如有)先计算主倍数,再算是否有presurge,再司机侧判断是否格子最优化、是否drivedecouple、是否driverdecoupedflag,再司机侧冒泡最优化,在乘客pax冒泡探索,最终返回dri pax dp。
`
flowchart TD
Start([“Process 入口”]) –> Init[“模块1-2 init 配置装配
拉 surgeConfig / 离线·实时特征
定两个司机解耦开关”]
Init –> DS[“模块3 供需过滤
DemandSupplyFilter → 定 IsDPTimes”]
DS –> Prep[“模块4 埋点 + initCustom
InitParams 拉倍数缓存”]
Prep –> Exp{“模块5 Explore
开启且命中?”}
Exp –>|命中| Ret((“return”))
Exp –>|未命中| Top{“IsDPTimes?”}
  subgraph A["分支 A:不出动调"]
      A0["SynTimesSDS=false 不写乘客热力图"] --> A1{"IsOpenPreSurge?"}
      A1 -->|是| A1a["LowerDsrPreSurge<br/>乘客=1 / 司机=PreSurgeCoef"]
      A1 -->|否| A2{"乘客动调开<br/>且缓存命中?"}
      A1a --> A2
      A2 -->|命中| A3["司机侧补算<br/>GridOpt→return / 独立 / 解耦"] --> ARet(("return"))
      A2 -->|未命中或未开| A4["乘客动调<br/>播单矩阵(NoSurge上限)+PaxSurge+TR"]
      A4 --> A5["司机侧三连击<br/>独立 → 解耦 → 冒泡最优化"]
      A5 --> A6["PaxBubExplore 乘客探索"]
      A6 --> A7{"有动调机制<br/>且倍数>1?"}
      A7 -->|是| A8["SyncDpTimes 落缓存"] --> ARet2(("return"))
      A7 -->|否| ARet2
  end

  subgraph B["分支 B:出动调 + 乘客动调开"]
      B1{"缓存命中?"} -->|命中| B1a["司机侧补算 → return"] --> BRet(("return"))
      B1 -->|未命中| B2["基础值构建<br/>paxDp=max(Filter,OptMin)<br/>drvDp=pax×解耦系数 · ±0.2区间"]
      B2 --> B3["乘客动调<br/>播单矩阵(Surge上下限)+PaxSurge+TR"]
      B3 --> B4["异步动调<br/>放大解耦系数(顶1.4)"]
      B4 --> B5{"!IfDriverDecouple?"}
      B5 -->|是| B5a["热力图输出 SetDpHeatMapCache"] --> B6
      B5 -->|否| B6["司机侧三连击<br/>独立 → 解耦 → 冒泡最优化"]
      B6 --> B7["CalculateDpTimes 上下限裁剪"]
      B7 --> B8["PaxBubExplore 乘客探索"]
      B8 --> B9{"司机解耦配置<br/>成功?"}
      B9 -->|是| B9a["覆盖司机倍数<br/>=DriverOptDpTimes"] --> B10["SyncDpTimes 落缓存(无条件)"]
      B9 -->|否| B10
  end

  subgraph C["分支 C:出动调 + 乘客动调关"]
      C1["DpHeatMapRange 先算热力图范围"] --> C2{"缓存命中?"}
      C2 -->|命中| C2a["司机侧补算 → return"] --> CRet(("return"))
      C2 -->|未命中| C3["热力图缓存 SetDpHeatMapCache"]
      C3 --> C4["OptSolve GMV最优化+拉格朗日<br/>失败 → FilterDPTimes 兜底"]
      C4 --> C5["异步动调<br/>直接放大 DecoupleCoef(顶1.4)"]
      C5 --> C6["CalculateDpTimes 上下限裁剪"]
      C6 --> C7["司机侧三连击<br/>独立 → 解耦 → 冒泡最优化"]
      C7 --> C8["PaxBubExplore 乘客探索"]
      C8 --> C9["SyncDpTimes 落缓存(无条件)"]
  end

  Top -->|false| A0
  Top -->|true| PB{"PaxSurgeConfig<br/>.IsOpen?"}
  PB -->|true| B1
  PB -->|false| C1

  Ret --> End
  ARet --> End
  ARet2 --> End
  BRet --> End
  B10 --> End
  CRet --> End
  C9 --> End
  End["模块9 metric 收尾<br/>defer: 计时 / 上报状态码 / CalcSurgeMetrics"] --> Done(["结束"])

  classDef core fill:#ffe6cc,stroke:#d79b00,stroke-width:2px;
  class A4,B3,C4 core;`
dp8的逻辑分支如下三张图所示,其中前两张里详细写了三分支里类似逻辑的实现,后一张是总体的分支走向:
文档里有一个比较全的如下:

optsolve是在供需过滤模块出isdptimes和!paxsurge.Isopen时,且未命中乘客dp缓存,走的逻辑,根据模型预估值和lambda系数计算优化动调倍数,函数头为
func (stg *DP8_0) OptSolve(ctx *common.Context) (dpTimes float64, err error)
关键步骤: