学习关于多treatment的uplift模型 此篇文章
Meta-learner:将treatment作为特征(S-learner)、或根据不同的treatment搭建多个模型(T-learner),这个已有许多py包可以实现。
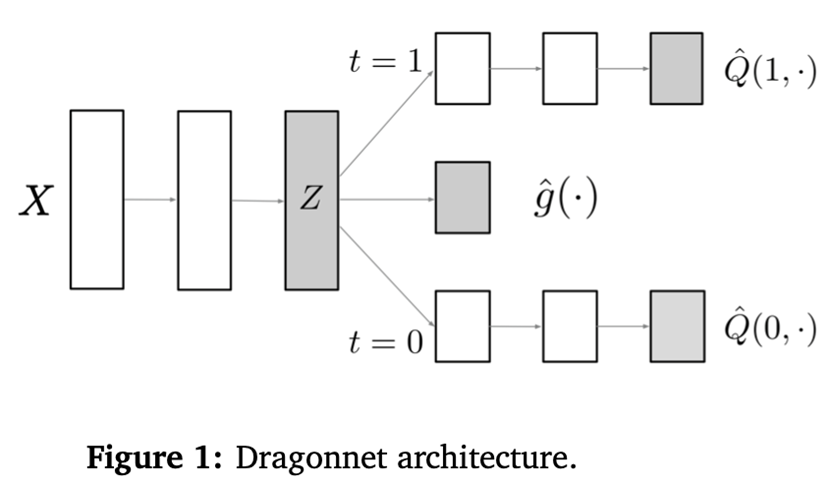
TarNet 提到了使用CFRNet/TarNet对多treatment进行建模,共享层表征X后,根据treatment的个数分到多头。
DRNet 提到了对于连续treatment的建模方法,DRNet是一个二维、多值干预模型,常用场景为“给一个用户发什么类型的优惠券、发券金额是多少”的二维多值干预。
uplift基础概念
- uplift的定义 && 矛盾的目标
Uplift models用于预测一个treatment的增量反馈价值,也就是lift的部分。
由于不能同时观测到对同一个用户对这两个值和(一个用户无法同时被干预+不干预),可以通过子人群的增益效果来推断个体的增益效果。
- uplift的几个重要概念
Uplift是Causal Inference的一个应用,通过计算cate(conditional average treatment effect)来估计ite(individual treatment effect)。记$Y_1$,$Y_0$为用户收到影响/不收到影响下的outcome。
- 因果效应uplift/个体的ite:$U = E[Y_1 - Y_0]$,即treatment和no treatment下的outcome的差值。可以表示treatment的增量价值。
- 用户实际被观测到的outcome:$ Y = Y_1 * T + Y_0 * (1 - T)$, 其中$Y_1$是treatment下的outcome,$Y_0$是no treatment下的outcome,$T$是treatment的0-1指示变量。
-
| 条件独立假设(CIA):$Y_1 \perp Y_0 |
X$,即在给定X的条件下,treatment和outcome是独立的(用户被分到实验组还是对照组和用户本身无关)
|
-
| 在CIA成立情况下,可以估算总体中子人群被干预的因果效应期望cate:$U = E[Y_1] - E[Y_0] = E[Y_1 |
X] - E[Y_0 |
X] = E[Y |
X,T=1] - E[Y |
X,T=0]$,即uplift等于实验组平均值和对照组平均值的差。
|
-
| 倾向分Propensity Score:$P(X) = P(T=1 |
X)$,即在给定X的条件下,用户被分到实验组(被干预)的概率。
|
-
Uplift Modeling
建模思路大致分为三种:
(1). 双模型:建立两个对于outcome的预测模型,一个在实验组数据一个在对照组数据。(T-learner)(以及它的变体X-learner)
通常作为baseline方法,对$E[Y_1|X]$,$E[Y_0|X]$分别建模,对于每一个用户做差计算出uplift。优点简单易用;缺点没有直接对uplift建模。
(2). class transoformation method:适用于Y是二分类的情况。(S-learner)
对于单个用户i,构造目标函数$ Z_i = {Y_i}^{obs} * T_i +(1 - {Y_i}^{obs}) * (1 - T_i)$,即在实验组下的outcome和对照组下的outcome的期望差。
满足条件 $p(x_i) = P(T=1|X_i) = 1/2 $ 时,uplift可以被表示为:$ U = E[Y_1|X] - E[Y_0|X] = P(Z = 1|X)- P[Z=0|X = P(Z = 1|X) - (1 - PC[Z=0|X]) = 2* P(Z = 1|X) - 1$
缺点:需要满足两个假设——1. 二分类场景,2. 数据在实验/对照组的分布一致,较为严格。可以拓宽到样本不均衡分布(倾向分不为1/2)的情况。
此时cate可以被写为: $Y_i = \frac{Y_i(1) * T_i }{P(T=1|X_i)} + \frac{Y_i(0) * (1 - T_i)}{1 - P(T=1|X_i)}$,即在实验组下的outcome和对照组下的outcome的期望差。
(3). 直接建模:直接对uplift进行建模。
uplift树模型Tree-Based Method,可以处理二分类treatment,改进方法使用cts(contextual treatment selection)可以处理多分类的treatment。
深度学习模型,直接对uplift建模。
- 四种meta-learner方法详细介绍
(1). T-learner
简介:差分响应模型,Two-model learner:先对于T=0的control组和T=1的treatment组分别学习一个有监督的模型。control组模型只用control组的数据,treatment组模型只用treatment组的数据。
原理:control组学习出的模型输出为 $u_0(x) = E[Y_0|X=x]$,treatment组的为 $u_1(x) = E[Y_1|X=x]$。
最终预测的uplift为 $U(x) = u_1(x) - u_0(x)$。
优点是原理简单,分组后分别拟合即可,缺点是误差累积,对response建模后做差得到的uplift,只能用于离散treatment。
(2). S-learner
简介:Single-model, 将treatment也作为一个特征输入到模型中,直接对uplift进行建模。
原理:训练一个机器学习模型,输出 $u(x) = E[Y|X=x, T=t]$ ,模型直接建模的还是response值,然后间接求出uplift $U(x) = u(x,T=1) -u(x,T=0) $。
优点是没分组,数据利用充分,缺点是还是间接建模uplift,且特征列X和treatment维度差距过大容易学崩。
(3). X-learner
简介:类似T-learner的小变体。
原理:先对treatment组和control组分别建模,得到 $u_1(x) = E[Y_1|X=x]$ 和 $u_0(x) = E[Y_0|X=x]$。(这步和T-learner一样)
得到两个模型后,分别计算control组和treatment组的diff:${D_i}^{1} = {Y_i}^1 - u_0({x_i}^1)$ 和 $D_i^{0} =u_1({x_i}^0)-{Y_i}^0$。注意这里出现的交叉,diff表示组内预测值和实际值的差。
再用两个机器学习模型来拟合这两个diff,得到 $d_1(x) = E[D^{1}|X=x]$ 和 $d_0(x) = E[D^{0}|X=x]$。
最后的uplift预测为 $U(x) = p(x) d_0(x) +(1-p(x)) d_1(x)$。p(x)是倾向分,注意这里又交叉一次。
(4). R-learner
原理:和dml类似,可以看作是原始的dml(如果看了causalml库的源码会发现,这个库里的dml是继承的R-learner)
- uplift evaluation
uplift评估最大的难点在于我们并没有单个用户uplift的ground truth,因此传统的评估指标像AUC是无法直接使用的。
- auuc(area under uplift curve)是uplift模型的评价指标。
- 第k个Uplift值的含义是:根据uplift score值从大到小对数据集D排序,即score值高的排在前面,前k个人中实验组平均产生的价值-前k个人中空白组平均产生的价值。依次类推,我们可以得到第1~n个Uplift值,可以根据此画出曲线。
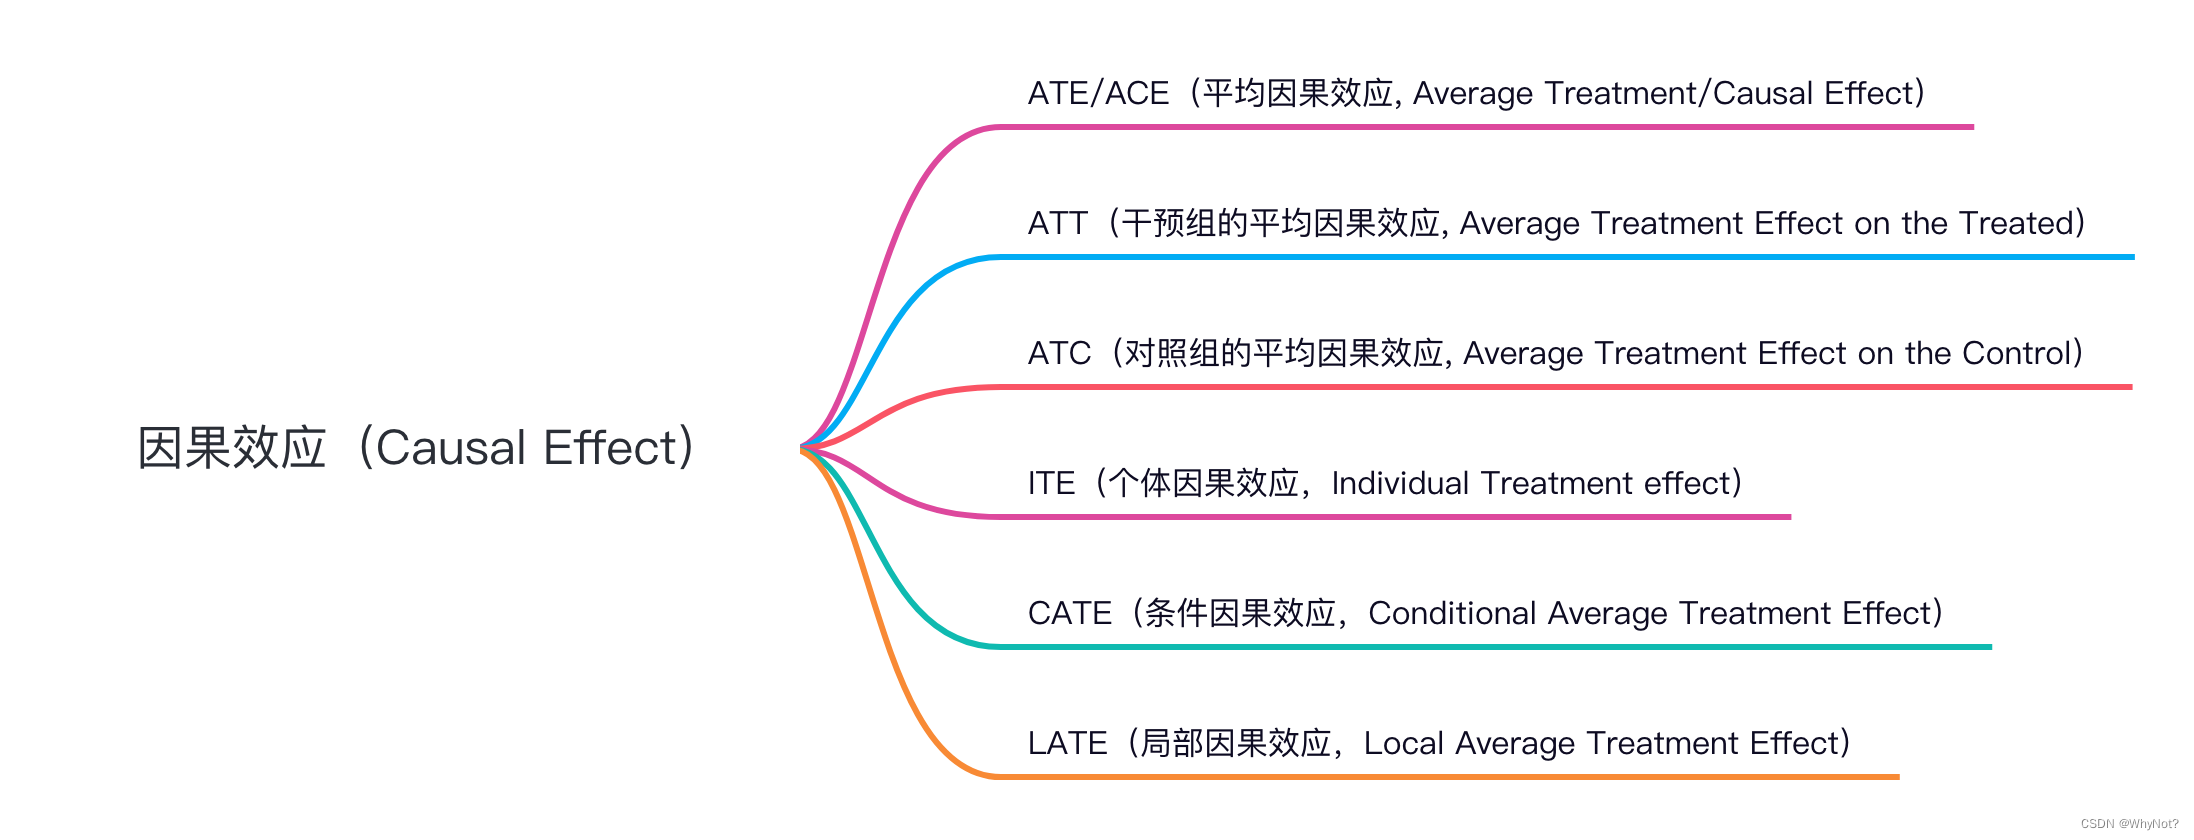
- ite 个体提升效果,对同一个对象,处理和不处理,outcome的差值,不可观测的,一个人不能既要又要。$ \tau_i = Y_i(T=1) - Y_i(T=0)$
-
| ate 平均提升效果,收到/不收到处理的outcome的差值,是一种估计;可能存在其他混淆变量导致两个组outcome有差异,因此存在偏差 $ate = E[Y |
X=1] - E[Y |
X=0]$ |
-
| att/atc 平均处理效果/平均控制效果,关注一部分对象,$ \tau_{att} = E[ |
Y_i(T=1) - Y_i(T=0) |
T=1]$, atc同理
|
-
| cate 条件平均处理效应,$\tau_{cate} = E[Y(1) - Y(0) |
X=x]$, cate是人群中某个subgroup的平均处理效应。 |
- 三组关系: $ate = E[ite] $
Correlation does not imply Causation
相关性不等于因果关系,相关性的主要来源如下图所示,包括Causation, Confounding, Selection Bias三种。
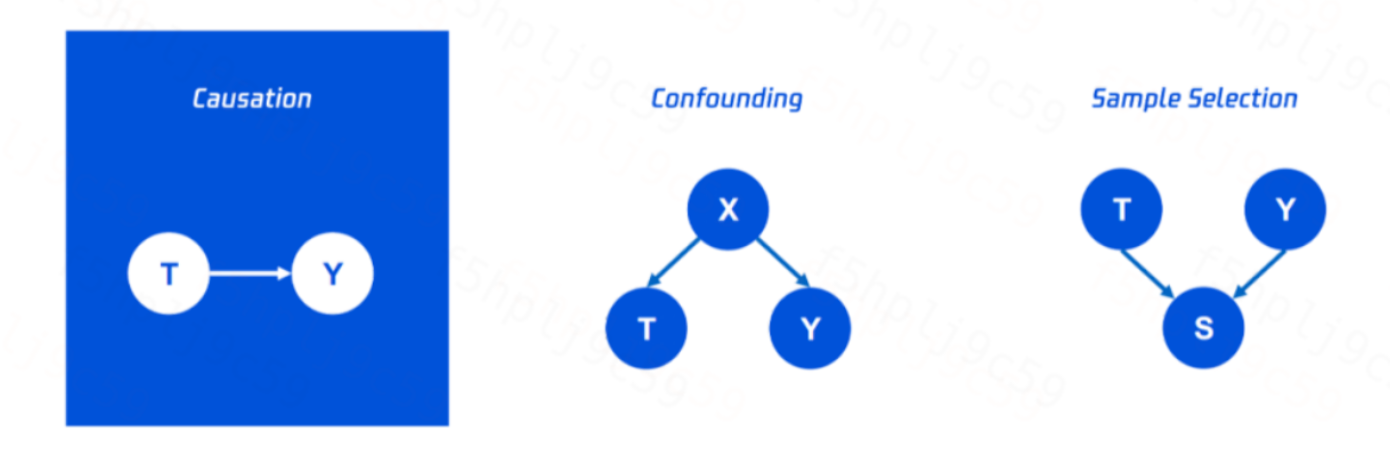
- Causation 因果:T导致Y的变化
- Confounding 混淆变量:存在一个变量X同时影响T和Y,导致T和Y相关, X同时和Y T 存在因果关系,但是T和Y之间没有因果关系。如夏天溺水人数和吃冰激凌人数关系,这中间的混淆变量就是气温。
- Selection Bias 选择偏差:样本选择不当导致T和Y相关。如医院病人数据中,吸烟和寿命的关系,可能是因为病人本身就比普通人更不健康。
潜在结果框架 Potential Outcome
事实结果 vs 反事实结果(以二值因果推断为例,以及混淆变量带来的偏差
事实结果:实施某种干预后观测到的结果
反事实结果:除了事实结果外,个体在其他干预下可能的结果,没有真正发生
$ ITE = Y(1) - Y(0)$
$ ATE = E[ITE] = E[Y(1)] - E[Y(0)] $
由于我们无法获得同一个个体的ITE,因此需要获得全体的ATE来估计个体的ITE,如果ATE如下估计:
$ ATE = E[Y|T=1] - E[Y|T=0] $, 会因为存在混淆变量导致出现偏差,这也是差分响应模型(T-learner)存在的问题:无法处理混淆变量。
表示学习在因果推断 :TARNet, CFRNet,
Motivation
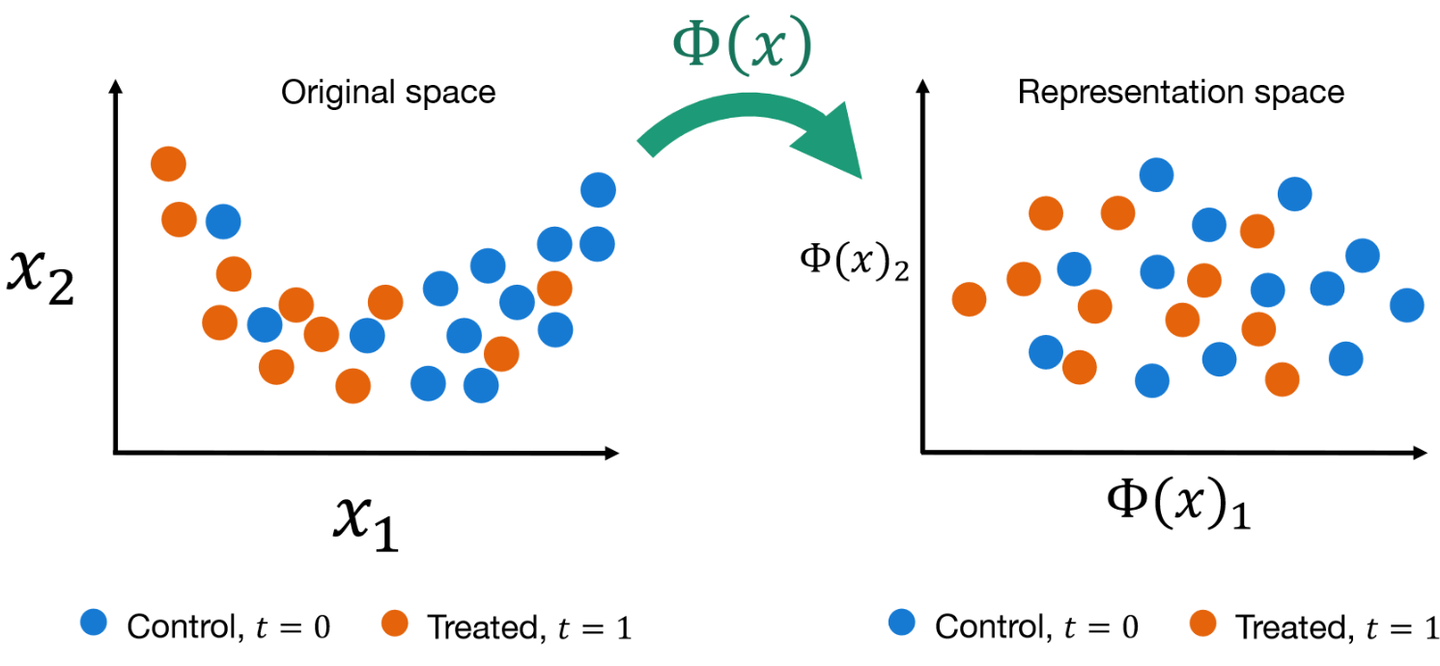
在混淆变量confounding的干预下treated组和control组的特征分布不一致。像T-learner这种模型对两个组分别建模时,两组分布差异过大,导致估计偏差。
因此可以将特征空间$X$映射到新的空间$ \phi (X)$ 中,使得treated组和control组的分布z在新空间中平衡: $ p(\phi(X)|T=1) \approx p(\phi(X)|T=0)$。这类似SVM的空间转换,也可以理解为一个经典的表示学习方法,因此可以用深度学习做。
TARNet - Treatment-Agnostic Representation Network
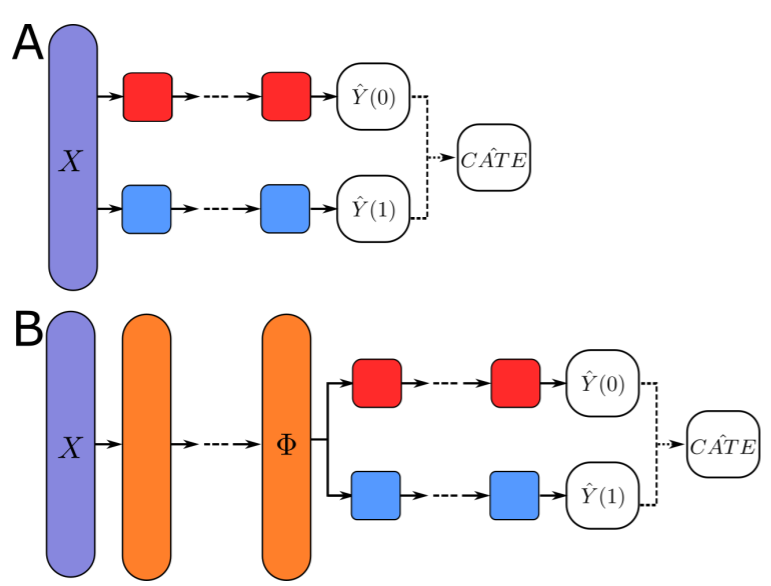
TARNet的核心思路是通过深度网络学习一个潜在的表示空间$\phi(X)$,使得treated组和control组在该空间中分布更接近,从而减少混淆变量带来的偏差,可以看出它在T-learner的基础上做改进。
下图为T-learner和TARNet的对比,TARNet通过共享层学习潜在表示$\phi(X)$,然后分别通过两个结果头预测treated组和control组的outcome。
Dragonnet
dragonnet的核心思路
传统的因果推断通过划分C/T组,计算得到两组间的插值进行估算 $U(x) = u_1(x) - u_0(x)$ 存在的问题是可能造成偏差。
因此做出如下改进点:(1)用深度网络寻找潜在的隐变量特征,避免出现 $u_1(x) - u_0(x)$ 之间的偏差;(2)输入不需要是所有变量。 (3)单纯训练两个结果头(如 TARNet)可能导致过度拟合处理组的模式。 加入倾向得分头并通过针对性正则化(targeted regularization) ,可以在估计ATE/ITE 时提高渐近效率
dragonnet的前置理论知识:Sufficiency of Propensity Score
-
| 如果ATE通过观测变量X来识别,那么ATE也可以通过倾向分P(T=1 |
X)来识别。用数学表述为:
|
|
|
| 如果 $ Y(0), Y(1) \perp T |
X$ ,那么 $Y(0), Y(1) \perp T |
P(T=1 |
X)$。
|
- 特征X可以分为四类 $ X = (X_c, X_t, X_y, X_e)$, 如下图所示
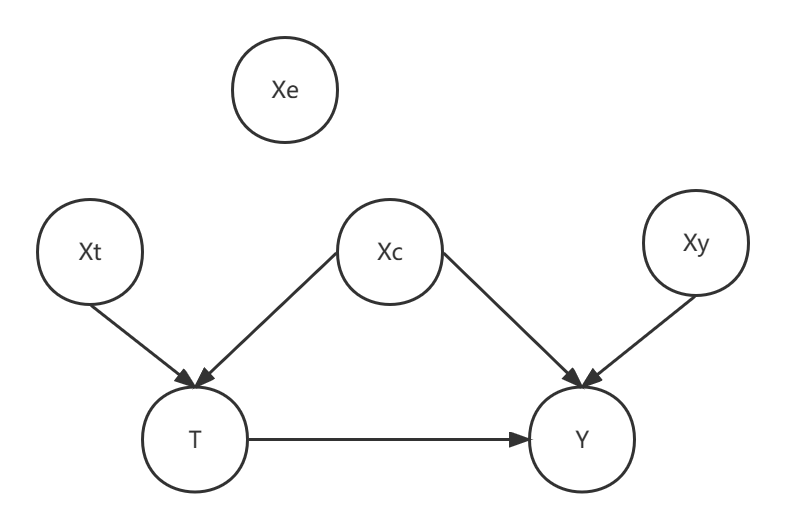
(1). $X_c$:confounder,混淆变量,又影响T又影响Y的变量,也是需要全放到模型中的变量
(2). $X_t$:仅影响T的变量,放到模型会导致因果估计出偏差
(3). $X_y$:仅影响Y的变量,对模型精度有提升
(4). $X_e$:不影响T和Y的变量,应该剔除
dragonnet的网络结构